- 헷갈리는 입모양도 앞뒤 문맥으로 해독
- 스마트글래스·군사용 로봇 활용 기대
[헤럴드경제=구본혁 기자] 시끄러운 공장이나 전장에서 목소리가 들리지 않아도 상대방의 입술 움직임만으로 대화 내용을 알아내는 인공지능(AI) 기술이 개발됐다. 향후 스마트글래스나 군사용 로봇에 탑재하면 소음이 극심한 환경에서도 음성 없이 의사소통이 가능할 전망이다.
KAIST는 전기및전자공학부 노용만 교수 연구팀이 입술 움직임만으로 상대방의 말을 문자로 바꾸는 ‘시각적 음성 인식(VSR)’ 기술의 정확도를 크게 높였다고 15일 밝혔다.
시각적 음성 인식은 소리 없이 입술 움직임만으로 발화 내용을 파악하는 기술이다. 하지만 서로 다른 단어라도 입술 움직임이 비슷한 경우가 많아 정확한 인식에 한계가 있었다.
기존 AI는 문장의 첫 단어부터 순서대로 해독하는 방식이어서 앞부분에서 단어를 잘못 인식하면 이후 문장까지 오류가 이어지는 문제가 있었다.
연구팀은 이러한 한계를 극복하기 위해 AI가 문장을 해독하는 순서를 바꿨다. 입술 움직임이 명확한 단어부터 먼저 인식하고, 이를 단서로 헷갈리는 부분을 앞뒤 문맥에 맞춰 해독하도록 했다.
마치 퍼즐에서 확실한 조각부터 맞춘 뒤 주변의 빈칸을 채워나가는 방식이다.
이를 위해 연구팀은 문장의 빈칸을 반복적으로 채워나가는 ‘확산 대형언어모델(DLLM)’을 활용했다. 입술 움직임과 문자 정보를 연결하는 학습과 문장 길이를 예측하는 학습을 단계적으로 진행해 인식 정확도를 높였다.
실제 문장을 해독할 때도 영상 길이를 바탕으로 여러 문장 길이를 추정하고, 각각의 결과를 비교해 가장 신뢰도 높은 문장을 선택하도록 했다.
성능도 입증했다. 연구팀이 433시간 분량의 입모양 영상 데이터셋 ‘LRS3’를 활용해 평가한 결과, 단어 오류율은 19.4%를 기록했다. LRS3만을 정답이 제공된 학습 데이터로 사용한 기존 기술 가운데 가장 낮은 수치다.
단어 오류율은 실제 발화 내용과 비교해 AI가 단어를 잘못 인식하거나 빠뜨리거나 추가한 비율로, 낮을수록 성능이 우수하다.
이번 기술은 청각장애인과 난청인의 의사소통을 돕는 스마트글래스는 물론 소음이 심한 산업 현장에서도 활용될 것으로 기대된다.
특히 국방 분야에서 활용 가능성이 주목된다. 폭발음과 기계 소음으로 음성 전달이 어려운 전장이나 은밀한 작전 수행이 필요한 상황에서 카메라만으로 아군의 명령을 인식하는 미래 국방 AI의 핵심 인터페이스로 발전시킬 수 있다는 설명이다.
연구팀은 향후 AI 모델을 소형 멀티모달 대형언어모델(sMLLM) 형태로 경량화해 스마트글래스와 엣지 로봇에 탑재하는 연구를 추진할 계획이다. 클라우드 서버에 연결하지 않고 기기 자체에서 실시간으로 입술 움직임을 읽고 자막으로 변환하는 온디바이스 AI 구현이 목표다.
노용만 교수는 “이번 연구는 인공지능이 단어를 생성하는 순서를 유연하게 제어하는 것만으로도 시각적 모호성을 지닌 음성 인식의 근본적 한계를 극복할 수 있음을 입증했다”며 “실제 생활과 산업 현장의 다양한 기기에서 신뢰하고 사용할 수 있는 피지컬 AI의 기반을 마련할 것”이라고 말했다.
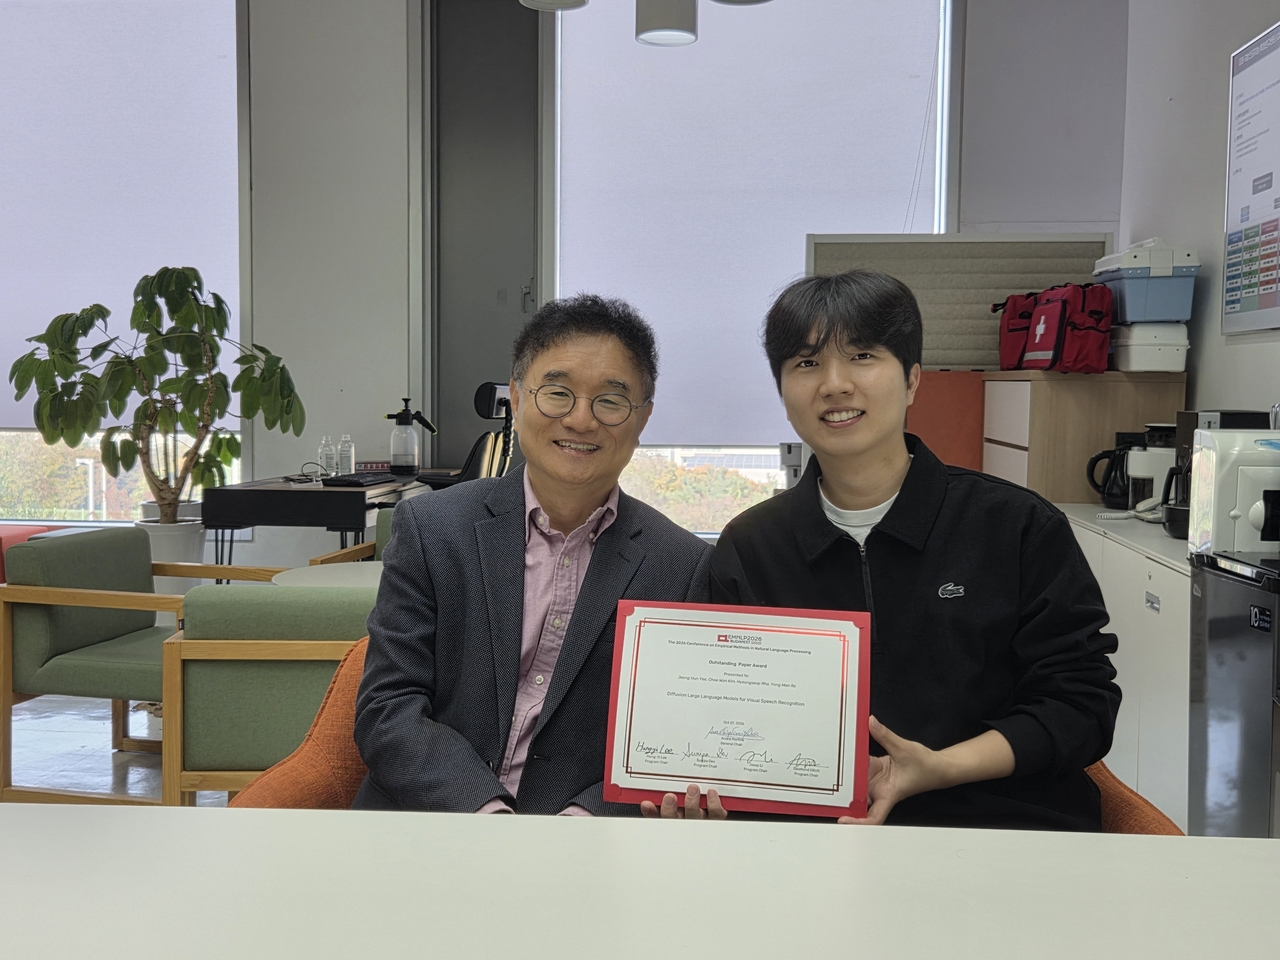
이번 연구에는 여정훈 KAIST 박사후연구원이 제1저자로 참여했다. 연구 성과는 자연어 처리 분야 국제학술대회 ‘EMNLP 2026’에서 우수논문상(Outstanding Paper Award)을 수상했다.
nbgkoo@heraldcorp.com