- 검색 정확도 유지 ‘CONDA’ 개발
- 1억개 데이터 환경서 성능 입증
[헤럴드경제=구본혁 기자] 국내 연구진이 데이터가 계속 추가되고 삭제되는 상황에서도 이 같은 ‘검색 길’을 유지해 AI가 최신 정보를 정확하게 찾아내는 기술을 개발했다. 검색증강생성(RAG)을 비롯해 기업 내부 지식검색과 상품 추천 등 실시간으로 정보가 변하는 AI 서비스의 성능을 끌어올릴 기술로 주목된다.
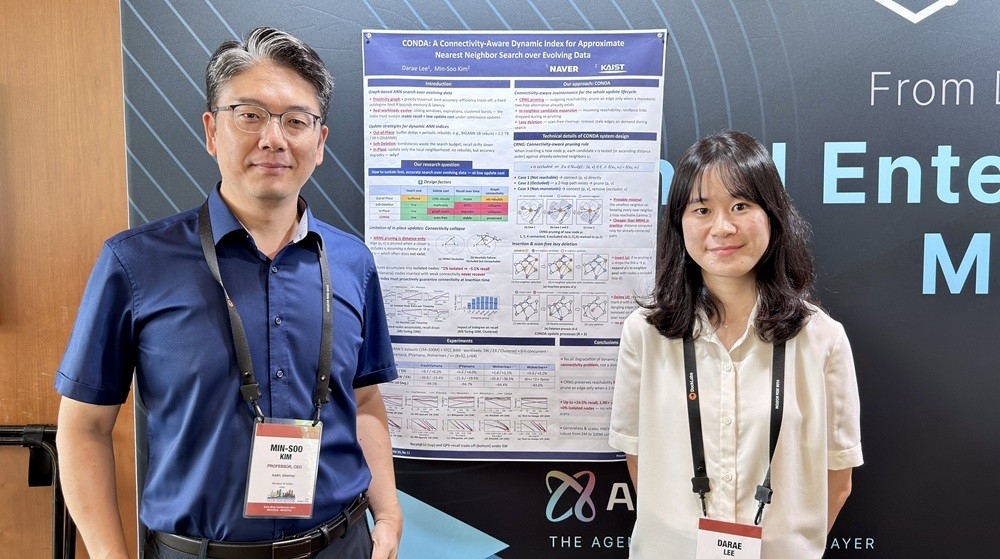
KAIST는 전산학부 김민수 교수 연구팀이 데이터가 지속적으로 추가·삭제되는 환경에서도 높은 검색 정확도를 유지하는 동적 벡터 검색 기술 ‘콘다(CONDA·Connectivity-Aware Dynamic Index)’를 개발했다고 5일 밝혔다.
생성형 AI는 학습을 마친 뒤 새로 등장한 정보를 스스로 알 수 없다. 이를 보완하기 위해 최신 뉴스나 기업 내부 문서 등을 검색해 답변에 활용하는 RAG 기술이 확산되고 있다.
RAG의 성능을 좌우하는 핵심 중 하나가 ‘벡터 검색’이다. 문서나 이미지의 의미를 컴퓨터가 계산할 수 있는 숫자 묶음인 벡터로 바꾼 뒤 의미가 비슷한 정보들을 서로 연결해 필요한 자료를 찾아내는 방식이다.
문제는 현실의 데이터가 끊임없이 변한다는 점이다. 새로운 뉴스와 문서, 상품 정보가 들어오는 동시에 기존 정보가 수정되거나 삭제된다. 이 과정이 반복되면 데이터 사이의 연결망이 조금씩 끊어지는 ‘연결성 붕괴’가 발생한다.
쉽게 말해 목적지는 그대로 있는데 그곳으로 가는 도로가 하나씩 사라지는 것과 같다. 필요한 정보가 데이터베이스에 존재하더라도 검색 경로가 끊기면 AI는 해당 정보를 찾아내지 못한다.
연구팀이 개발한 CONDA는 데이터 사이의 거리뿐 아니라 필요한 정보까지 도달할 수 있도록 검색 경로가 제대로 연결돼 있는지를 함께 고려한다. 새로운 데이터가 들어오거나 기존 데이터가 삭제되더라도 중요한 연결을 보존해 특정 정보가 검색망에서 고립되는 것을 막는다.
CONDA는 데이터 추가와 삭제가 지속적으로 이뤄지는 환경에서 기존 최신 기술보다 검색 정확도를 최대 24.5% 높였다. 데이터 처리 속도도 최대 1.90배 빨랐다.
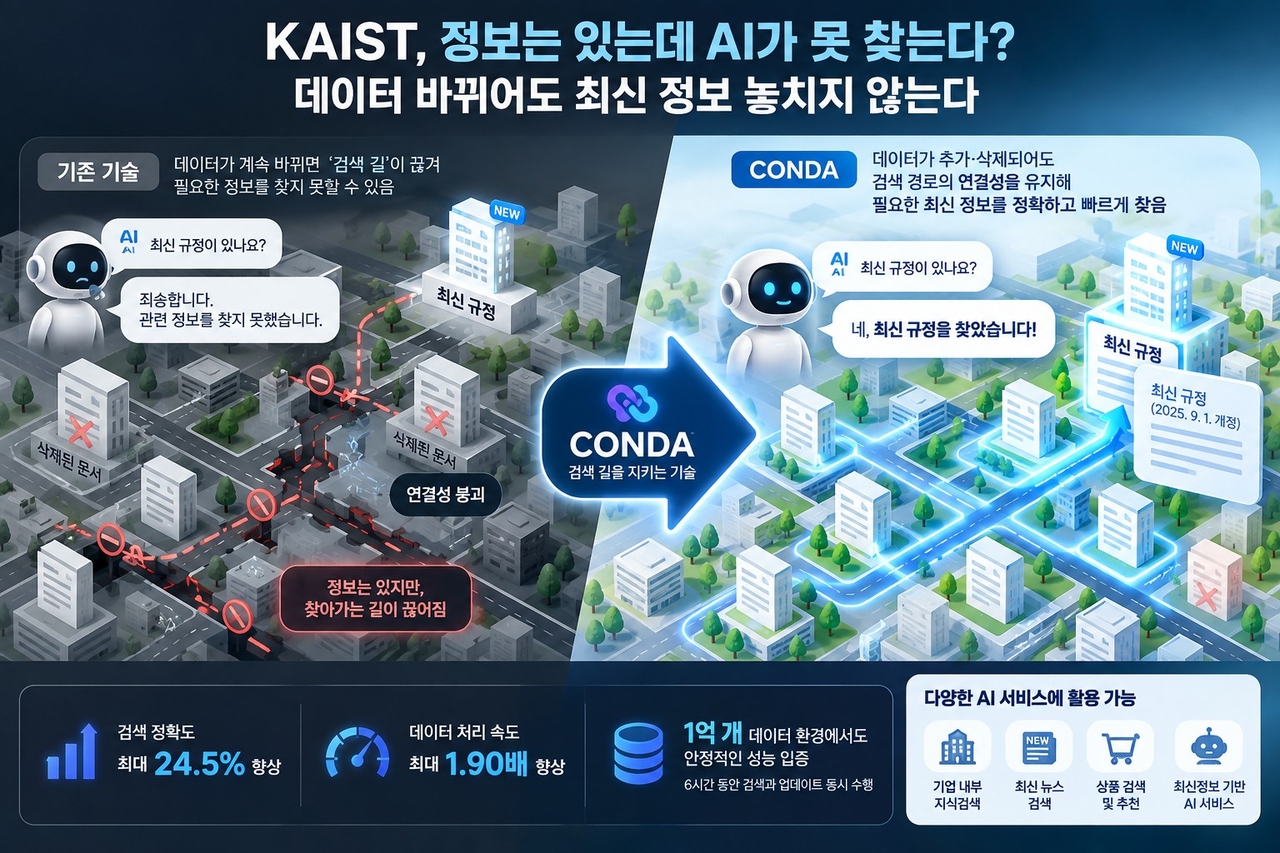
특히 연구팀은 1억개의 데이터가 존재하는 대규모 환경에서 6시간 동안 검색과 데이터 업데이트를 동시에 진행했다. CONDA는 비교 기술 가운데 가장 짧은 응답시간과 높은 검색 정확도를 유지했다. 실제 대규모 AI 서비스에 적용할 수 있는 가능성을 확인한 것이다.
활용 범위도 넓다. 최신 문서를 계속 반영해야 하는 RAG 기반 생성형 AI를 비롯해 사용자와 상품 정보가 실시간으로 변하는 추천시스템, 뉴스·소셜미디어·전자상거래 검색 등에 적용할 수 있다.
현재 많은 검색 시스템은 변경된 데이터를 따로 쌓아두거나 일정 시점마다 검색 구조 전체를 다시 만드는 방식을 사용한다. 데이터 규모가 커질수록 재구축에 필요한 시간과 컴퓨팅 자원이 늘어난다는 한계가 있다. CONDA는 바뀐 부분을 직접 갱신하면서도 핵심 검색 경로를 유지해 전체 검색 구조를 반복적으로 재구축해야 하는 부담을 낮출 수 있다.
김 교수가 창업한 AI 데이터 인프라 기업 그래파이(GraphAI)의 통합 데이터베이스 제품 ‘아카식DB(AkasicDB)’에 CONDA 기술을 적용하고 있다. CONDA 기반 동적 벡터 검색 기술을 탑재한 버전은 올해 4분기 출시할 예정이다.
김 교수는 “RAG의 중요한 가치는 대규모언어모델(LLM)이 학습하지 못한 최신 정보를 필요한 순간 즉시 찾아 활용할 수 있다는 점”이라며 “데이터가 끊임없이 변하는 현실에서도 AI가 오랜 시간 정확하게 최신 지식을 활용할 수 있는 데이터 인프라를 제시했다는 데 의미가 있다”고 말했다.
이번 연구결과는 데이터베이스 분야 국제학술대회 ‘VLDB 2026’에서 발표됐다.
nbgkoo@heraldcorp.com